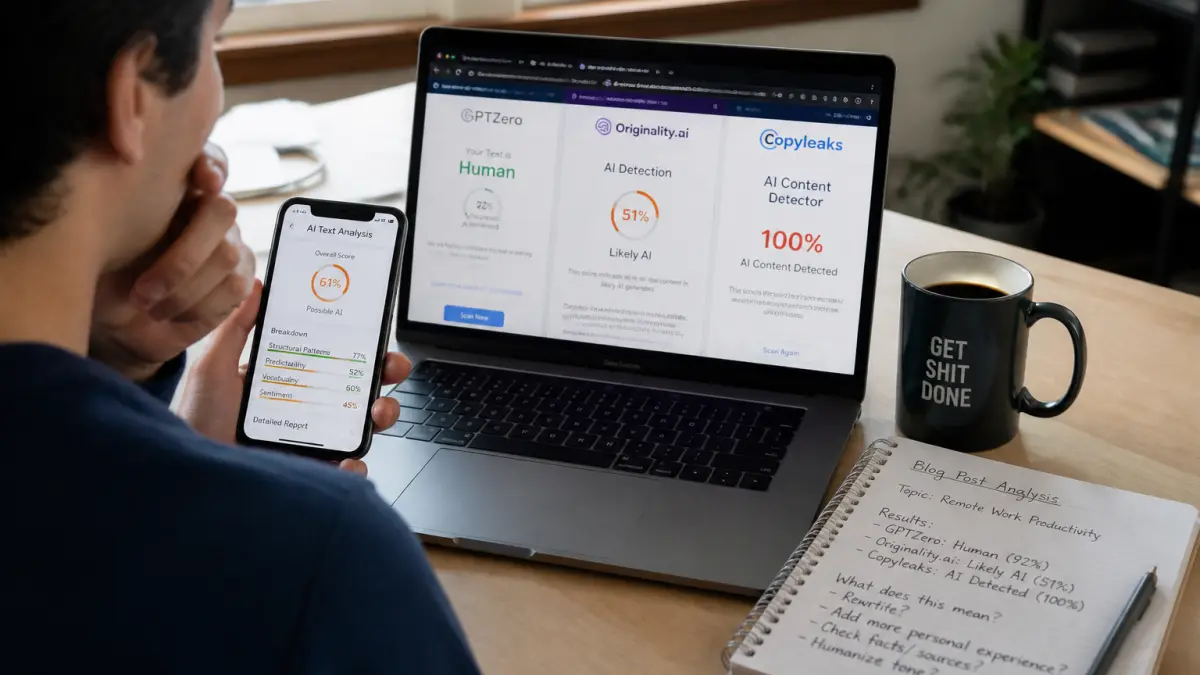
Vous avez déjà collé un même texte dans trois détecteurs d’IA différents et obtenu trois réponses contradictoires ? Un outil vous dit “100 % humain”, un autre “80 % IA”, le troisième reste perplexe. Ce n’est pas un bug, ni un complot. C’est le résultat direct de la manière dont ces outils sont construits. Chaque détecteur repose sur des modèles de langage, des méthodes de calcul et des seuils de décision qui lui sont propres. Comprendre ces différences vous évitera de prendre un score pour une vérité absolue.
Comment un détecteur d’IA analyse-t-il un texte ?
Pour savoir pourquoi les résultats varient, il faut d’abord comprendre le fonctionnement commun à presque tous ces outils. Ils ne “lisent” pas le texte comme un humain. Ils le découpent en motifs statistiques et mesurent deux choses principales : la perplexité et l’éclatement (burstiness).
La perplexité évalue à quel point un texte est prévisible. Un humain écrit de manière plus irrégulière : phrases longues et complexes, puis courtes et abruptes, choix de mots inattendus. Une IA comme ChatGPT, entraînée à maximiser la probabilité du mot suivant, produit un texte plus “lisse”, moins surprenant. Un texte avec une perplexité faible (très prévisible) sera donc plus souvent étiqueté “IA”.
L’éclatement mesure la variation de cette perplexité. Les humains alternent entre des passages très prévisibles et d’autres très surprenants. L’IA a tendance à maintenir un niveau de perplexité plus constant. Chaque détecteur combine ces deux mesures avec ses propres pondérations et seuils. C’est la première source de variation : un outil peut donner plus de poids à la perplexité, un autre à l’éclatement.
Les quatre raisons principales des écarts entre les outils
1. Des modèles d’entraînement différents
Chaque détecteur est lui-même un modèle de langage, entraîné sur des jeux de données différents. L’un a été nourri avec des milliers de textes de blogs techniques, un autre avec des dissertations universitaires, un troisième avec des articles de presse. Si votre texte ressemble au type de contenu sur lequel l’outil a été entraîné, le score sera plus fiable pour ce type précis. Mais un détecteur entraîné sur l’anglais aura du mal avec un texte français, même s’il prétend le supporter. La plupart des outils sont conçus pour l’anglais, et leur performance chute sur d’autres langues, car les modèles GPT sous-jacents produisent des motifs différents selon la langue.
2. Des seuils de décision arbitraires
Un outil peut classer “IA” tout texte dont le score dépasse 70 %. Un autre ne le fera qu’à partir de 90 %. Certains utilisent une échelle binaire (humain/IA), d’autres un pourcentage, d’autres encore des étiquettes comme “probablement IA” ou “difficile à déterminer”. Ces seuils sont choisis par les développeurs, pas dictés par une loi mathématique. Un même texte peut donc passer la barre chez un outil et pas chez un autre.
3. La sensibilité à la longueur et à la langue du texte
Les détecteurs ont besoin d’un volume minimum de mots pour produire une analyse statistiquement significative. En dessous de 100 ou 150 mots, le résultat devient aléatoire. De plus, la plupart des outils gratuits limitent la longueur du texte analysable. Si vous coupez un article en deux pour respecter cette limite, les deux moitiés peuvent donner des scores différents, car la perplexité n’est pas uniforme sur l’ensemble du texte.
La langue pose un problème encore plus grand. Les modèles d’IA générative sont majoritairement entraînés sur l’anglais. Un détecteur qui fonctionne bien sur un texte en anglais peut surévaluer la probabilité IA sur un texte en français, simplement parce que les motifs statistiques du français lui sont moins familiers. Les textes traduits automatiquement (via DeepL ou Google Translate) ajoutent une couche de complexité : ils portent les marques de la traduction automatique, ce qui peut brouiller l’analyse.
4. Des méthodes de notation différentes
Certains outils affichent un pourcentage simple. D’autres utilisent un code couleur (vert, orange, rouge). D’autres encore fournissent une analyse phrase par phrase. Cette différence de présentation n’est pas anodine : un score à 52 % peut être affiché comme “incertain” par un outil et comme “probablement IA” par un autre, selon la manière dont le résultat est interprété et présenté à l’utilisateur.
Les pièges à éviter quand on utilise un détecteur
- Ne jamais prendre un score isolé comme preuve définitive. Un détecteur ne “prouve” rien, il estime une probabilité. Un score de 95 % ne signifie pas que le texte est à 95 % généré par une IA, mais que le modèle estime à 95 % que ce texte ressemble à ceux sur lesquels il a été entraîné comme “IA”.
- Méfiez-vous des faux positifs sur les textes très courts. Un tweet, un slogan ou un titre ne donneront jamais un résultat fiable. La statistique a besoin de volume.
- Attention aux textes très techniques ou très standardisés. Un mode d’emploi, une fiche produit ou une recette de cuisine ont une structure si prévisible qu’ils peuvent être classés “IA” même s’ils sont écrits par un humain. Inversement, un texte d’IA peut imiter un style humain en y ajoutant volontairement des irrégularités.
- Ne pas confondre détecteur IA et logiciel anti-plagiat. Un anti-plagiat cherche des similitudes avec des sources existantes. Un détecteur IA analyse le style d’écriture, même sur un texte original. Les deux ne répondent pas à la même question.
Ce que disent les tests comparatifs
Des tests réalisés sur des échantillons de 20 textes (10 humains, 10 IA) montrent des écarts significatifs entre les outils populaires. Certains classent correctement les textes humains mais échouent sur les textes d’IA, d’autres font l’inverse. Aucun outil n’atteint 100 % de fiabilité, et les résultats varient selon le type de contenu (article de blog, texte littéraire, document technique). Un détecteur performant sur des articles de presse peut être mauvais sur des extraits de romans.
Le tableau ci-dessous résume les différences observées entre quatre outils testés sur un même échantillon :
| Outil | Méthode de notation | Fiabilité sur textes humains | Fiabilité sur textes IA | Limite de longueur (version gratuite) |
|---|---|---|---|---|
| Outil A | Pourcentage (0-100 %) | Bonne (8/10 corrects) | Moyenne (6/10 corrects) | 1 500 caractères |
| Outil B | Échelle binaire (humain/IA) | Excellente (10/10) | Faible (4/10) | 500 mots |
| Outil C | Code couleur + score phrase par phrase | Moyenne (7/10) | Bonne (8/10) | 2 000 caractères |
| Outil D | Probabilité + étiquette verbale | Bonne (9/10) | Bonne (7/10) | 1 000 mots |
Les noms des outils sont volontairement omis : les performances évoluent rapidement avec les mises à jour. Ce tableau illustre le principe de variation, pas un classement définitif.
Comment interpréter les résultats sans se faire piéger
La règle d’or : un détecteur est un outil d’aide, pas un juge. Il donne une indication, pas une certitude. Pour éviter les conclusions erronées, croisez toujours les résultats d’au moins deux outils différents. Si les deux convergent, l’indication est plus solide. S’ils divergent, le texte est probablement dans une zone grise où l’analyse humaine est indispensable.
Gardez en tête que les textes générés par IA évoluent. Les modèles comme ChatGPT sont mis à jour régulièrement, et leurs “marques” stylistiques changent. Les détecteurs doivent s’adapter en permanence, ce qui crée un décalage entre la sortie d’un nouveau modèle et la capacité des détecteurs à le reconnaître. Un texte généré par la dernière version de ChatGPT peut passer inaperçu aux yeux d’un détecteur entraîné sur une version antérieure.
Enfin, n’oubliez pas qu’un humain peut imiter le style d’une IA (phrases courtes, vocabulaire répétitif, absence de parti pris) et qu’une IA peut, avec les bons réglages, imiter le style d’un humain (en introduisant volontairement des erreurs, des variations de longueur de phrases, des opinions marquées). La frontière devient floue, et les détecteurs peinent à la tracer proprement.
Pour approfondir la question et comprendre comment analyser les résultats d’un détecteur, vous pouvez consulter notre guide sur le fonctionnement et l’interprétation des scores d’un détecteur d’IA gratuit.
La seule attitude fiable face à un score de détection
Ne cherchez pas un outil parfait : il n’existe pas. La variation des résultats entre les détecteurs est structurelle, pas accidentelle. Elle tient aux choix techniques de chaque développeur, aux données d’entraînement, aux seuils fixés et à la langue du texte. Faire confiance aveuglément à un seul outil, c’est prendre le risque d’accuser à tort ou de laisser passer un contenu généré par IA.
La bonne pratique, c’est d’utiliser ces outils comme un premier filtre, pas comme une preuve. Si vous devez trancher sur l’origine d’un texte (pour un travail académique, un recrutement, une publication), combinez l’analyse automatique avec une relecture humaine attentive aux signes classiques : absence de fautes de frappe, style trop lisse, répétitions, manque de parti pris, incohérences factuelles. C’est le croisement des indices, pas un score unique, qui permet de se rapprocher d’une réponse fiable.